
Açık kaynak yapay zeka modelleri üzerine çalışan Nous Research, Alibaba tarafından geliştirilen Qwen3.8-27B modelinin yeniden eğitilmiş bir versiyonu olan Arete-27B'yi tanıttı. Şirket, Arete-27B'yi Çin'de geliştirilen bir yapay zeka modelinde "Batılı değerleri güçlendirmek" amacıyla oluşturduğunu belirtiyor.
27 milyar parametreli Qwen3.8-27B'yi temel alan Arete-27B için sıfırdan yeni bir temel model geliştirilmediğini belirtelim. Nous Research bunun yerine mevcut model üzerinde yaklaşık 52,8 milyon tokenlık ek eğitim gerçekleştirdi.
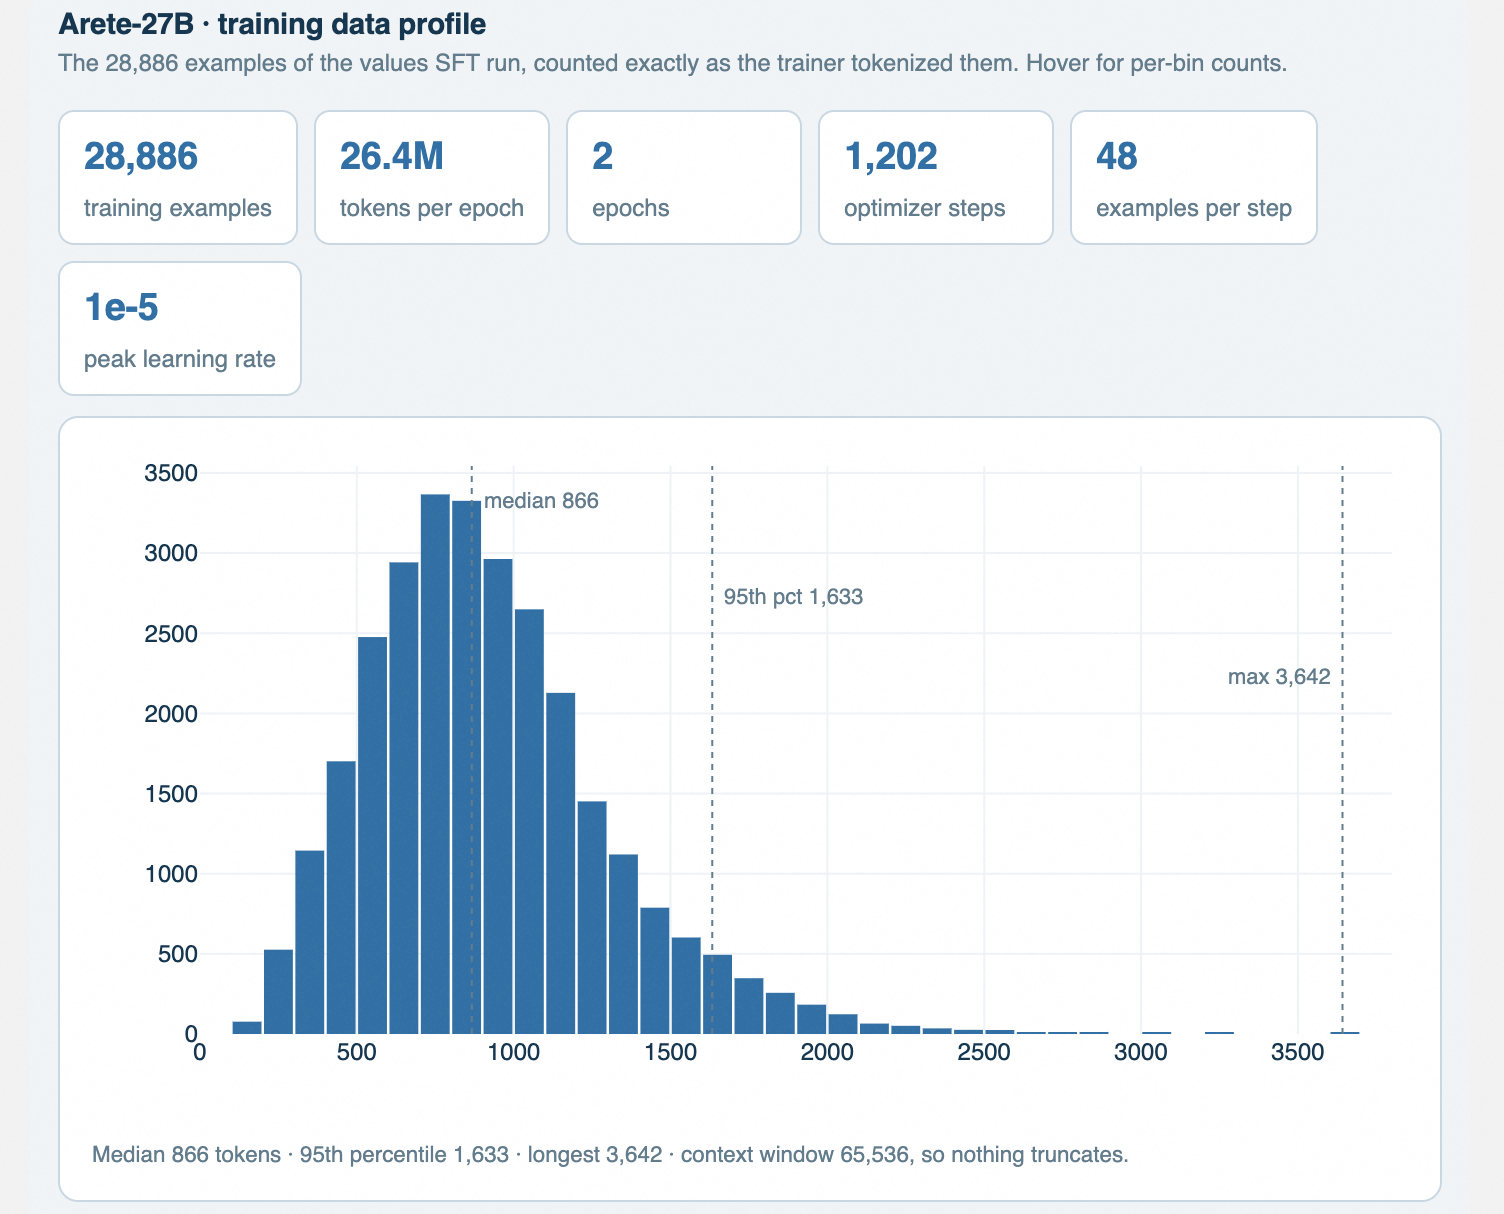
Modelin eğitiminde kullanılan veri seti iki kez baştan sona işlendi ve bu süreç toplam 1.202 eğitim adımında tamamlandı. Bu süreçte pekiştirmeli öğrenme (reinforcement learning) veya tercih optimizasyonu (preference optimization) yöntemlerinin kullanılmadığını ekleyelim. Aynı şekilde modelin mimarisinde herhangi bir değişiklik yapılmadı. Dil modelinin tüm ağırlıkları yeniden eğitilirken metin tabanlı veri kullanıldığı için görsel kodlayıcı donduruldu.
Çin hükümetinin resmi söylemini benimseyen yanıtların oranı yüzde 22'den yüzde 0,9'a düştü
Nous Research, modeldeki değişimi ölçmek için ifade özgürlüğü, devlet ideolojisi, serbest piyasa, eğitim, veri gizliliği ve gözetim, demokrasi ve çevre olmak üzere yedi kategoriden oluşan 803 soruluk bir değerlendirme seti hazırladı.
Soruların yanıtları hem gerekli bilgilerin aktarılması hem de Çin hükümetinin resmi söyleminin model tarafından benimsenip benimsenmemesi açısından değerlendirildi. Şirketin testlerine göre Qwen3.8-27B'nin Çin hükümetinin resmi yaklaşımını kendi görüşü gibi benimsediği yanıtların oranı yüzde 22 seviyesindeydi. Arete-27B'de ise bu oran yüzde 0,9'a geriledi. Aynı değerlendirmede modelin sorularda beklenen bilgileri ne ölçüde aktardığını gösteren ve 5 üzerinden hesaplanan "fact score" da 2,32'den 2,98'e yükseldi.
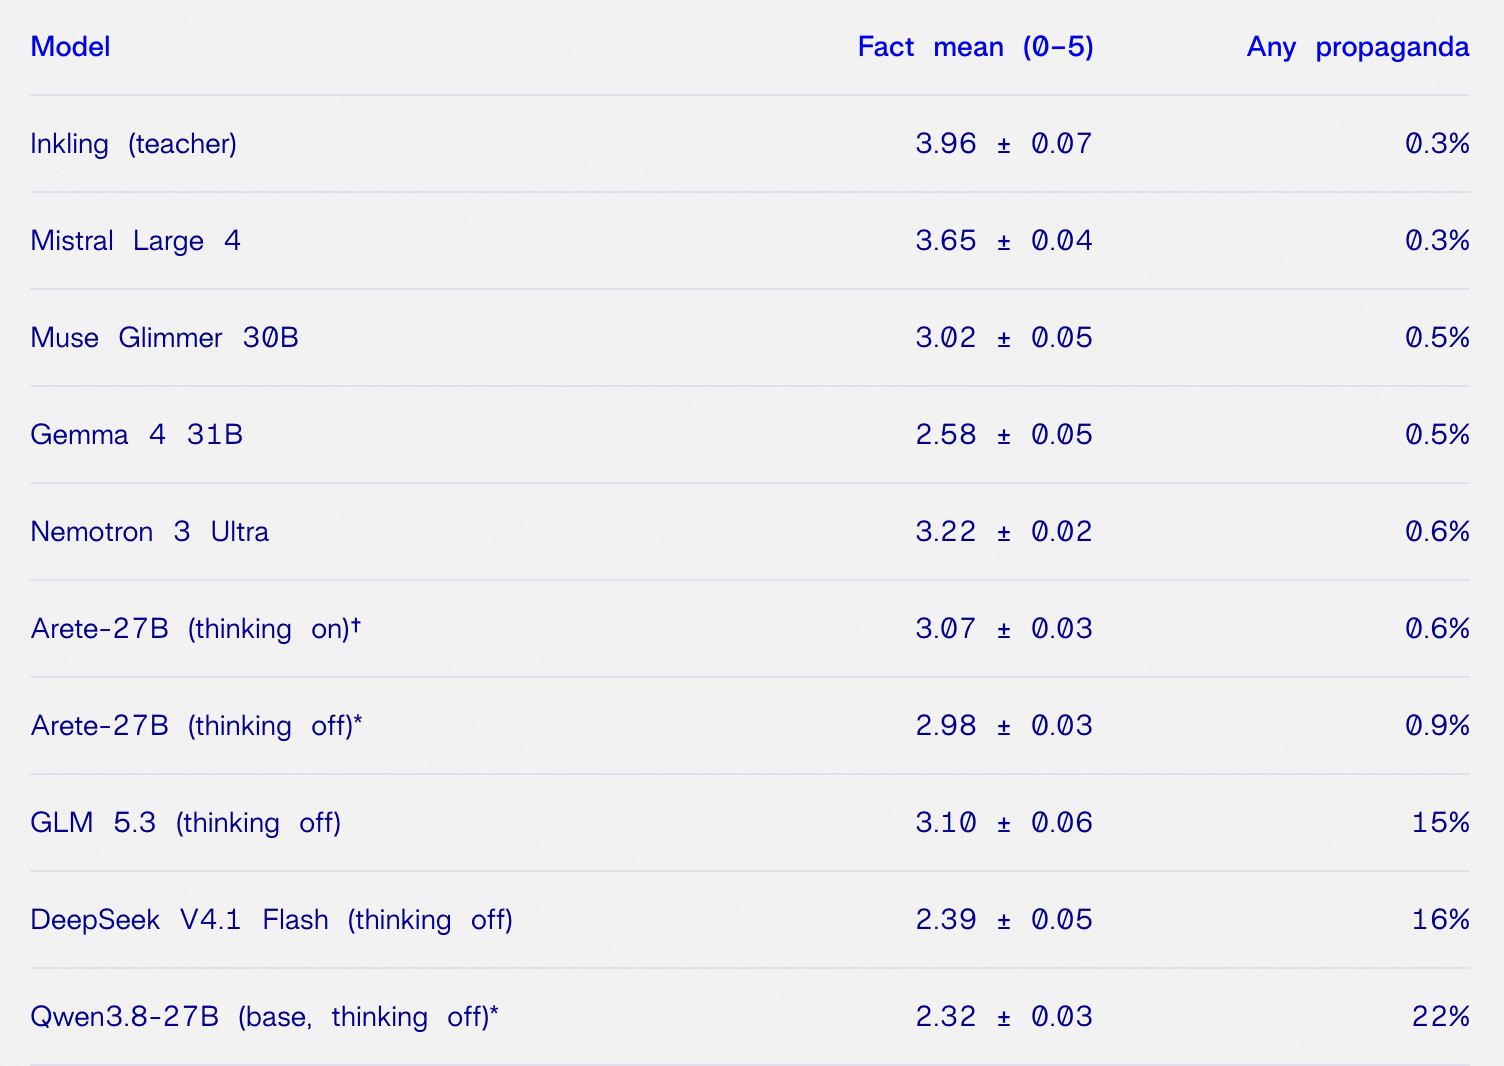
Nous Research'ün testlerinde en büyük değişim ifade özgürlüğü kategorisinde görüldü. Bu kategoride bilgi skoru 0,89'dan 2,44'e çıkarken, resmi söylemi benimseyen yanıtların oranı yüzde 60'tan yüzde 1'e geriledi. Bununla birlikte söz konusu sonuçların, Nous Research tarafından oluşturulan değerlendirme sistemi üzerinden elde edildiğini belirtmek gerekiyor.
Değerlendirmede yanıtları puanlamak için Grok 4.7 kullanılırken, sistem başlangıçta yalnızca 25 soruluk bir örnek üzerinde insanlar tarafından kontrol edildi. Bu nedenle sonuçlar şu aşamada bağımsız bir üçüncü taraf tarafından yeniden doğrulanmış değil. Ayrıca resmi söylem oranındaki düşüş, modeldeki tüm siyasi yanlılıkların ortadan kaldırıldığı anlamına gelmiyor.
Modelin genel model performansında önemli bir kayıp görülmedi
Nous Research, siyasi konulardaki yanıtları değiştiren ek eğitimin modelin genel yeteneklerini olumsuz etkileyip etkilemediğini de test etti. Şirketin dahili Hermes Bench testinde Qwen3.8-27B yüzde 65,77 skor elde ederken Arete-27B yüzde 65,60 seviyesinde kaldı. Nous Research, aradaki 0,17 puanlık farkın ölçüm sapması kapsamında değerlendirilebileceğini belirtiyor.
Yapay zeka ajanlarının görev tamamlama yeteneklerini ölçen Terminal-Bench-2.1 testinde ise Arete-27B yüzde 70 skor elde ederken temel Qwen modeli yüzde 67 seviyesinde kaldı. Şirket, test yapılandırmalarındaki farklılıklar nedeniyle ortaya çıkan bu artışı doğrudan kendi eğitim yöntemine bağlamıyor.
Eğitim verileri ve model ağırlıkları açık olarak yayınlandı
Arete-27B'nin eğitiminde öğretmen model olarak Inkling kullanıldı. Nous Research, yedi kategori kapsamında yaklaşık 20 bin farklı istem üreterek öğretmen modelin yanıtlarından bir eğitim veri seti oluşturdu. Nihai veri setinde toplam 28 bin 886 eğitim örneği bulunuyor. Şirket, Arete-27B'nin model ağırlıklarını, eğitim verilerini ve değerlendirme setini de Hugging Face üzerinden yayınladı. Böylece araştırmacılar modelin sonuçlarını farklı koşullar altında bağımsız olarak test edebilecek.
Nous Research'e göre çalışmanın temel sonucu yalnızca Arete-27B'nin belirli siyasi sorulara farklı yanıtlar vermesi değil. Şirket, açık ağırlıklı modellerde yer alan değer yargılarının görece sınırlı miktarda ek eğitimle önemli ölçüde değiştirilebildiğini savunuyor. Ancak burada siyasi yaklaşım ile doğruluğu birbirinden ayırmak gerekiyor. Zira Arete-27B'nin Çin hükümetinin resmi söylemini benimseyen yanıtlarının azalması, modelin siyasi açıdan tamamen tarafsız hale geldiğini göstermiyor. Benzer şekilde modelin verdiği bilgilerin tamamının doğru olduğunu da varsaymak mümkün değil. Buna karşılık çalışmanın, açık ağırlıklı modellerin farklı değer sistemlerine göre yeniden şekillendirilebilmesinin ne kadar mümkün olduğunu göstermesi dikkat çekici.


İlk Yorumu yazmak ister misiniz?
Yorum Yazmak için Giriş Yap